 Zero
Nexdata、Interspeech2026に出展。多言語話者分離をテーマにしたワークショップも開催、世界で有名な音声研究者が登壇
Nexdata、Interspeech2026に出展。多言語話者分離をテーマにしたワークショップも開催、世界で有名な音声研究者が登壇 Datatang株式会社のプレスリリース
Datatang株式会社がPR TIMESで配信したプレスリリースの原文を、Zero Press が転載して掲載しています。
AI学習用データプロバイダーNexdataは、音声言語処理分野の最高峰国際会議「Interspeech 2026」(開催地:オーストラリア・シドニー、開催期間:2026年9月27日~10月1日)への出展を正式に発表いたしました。
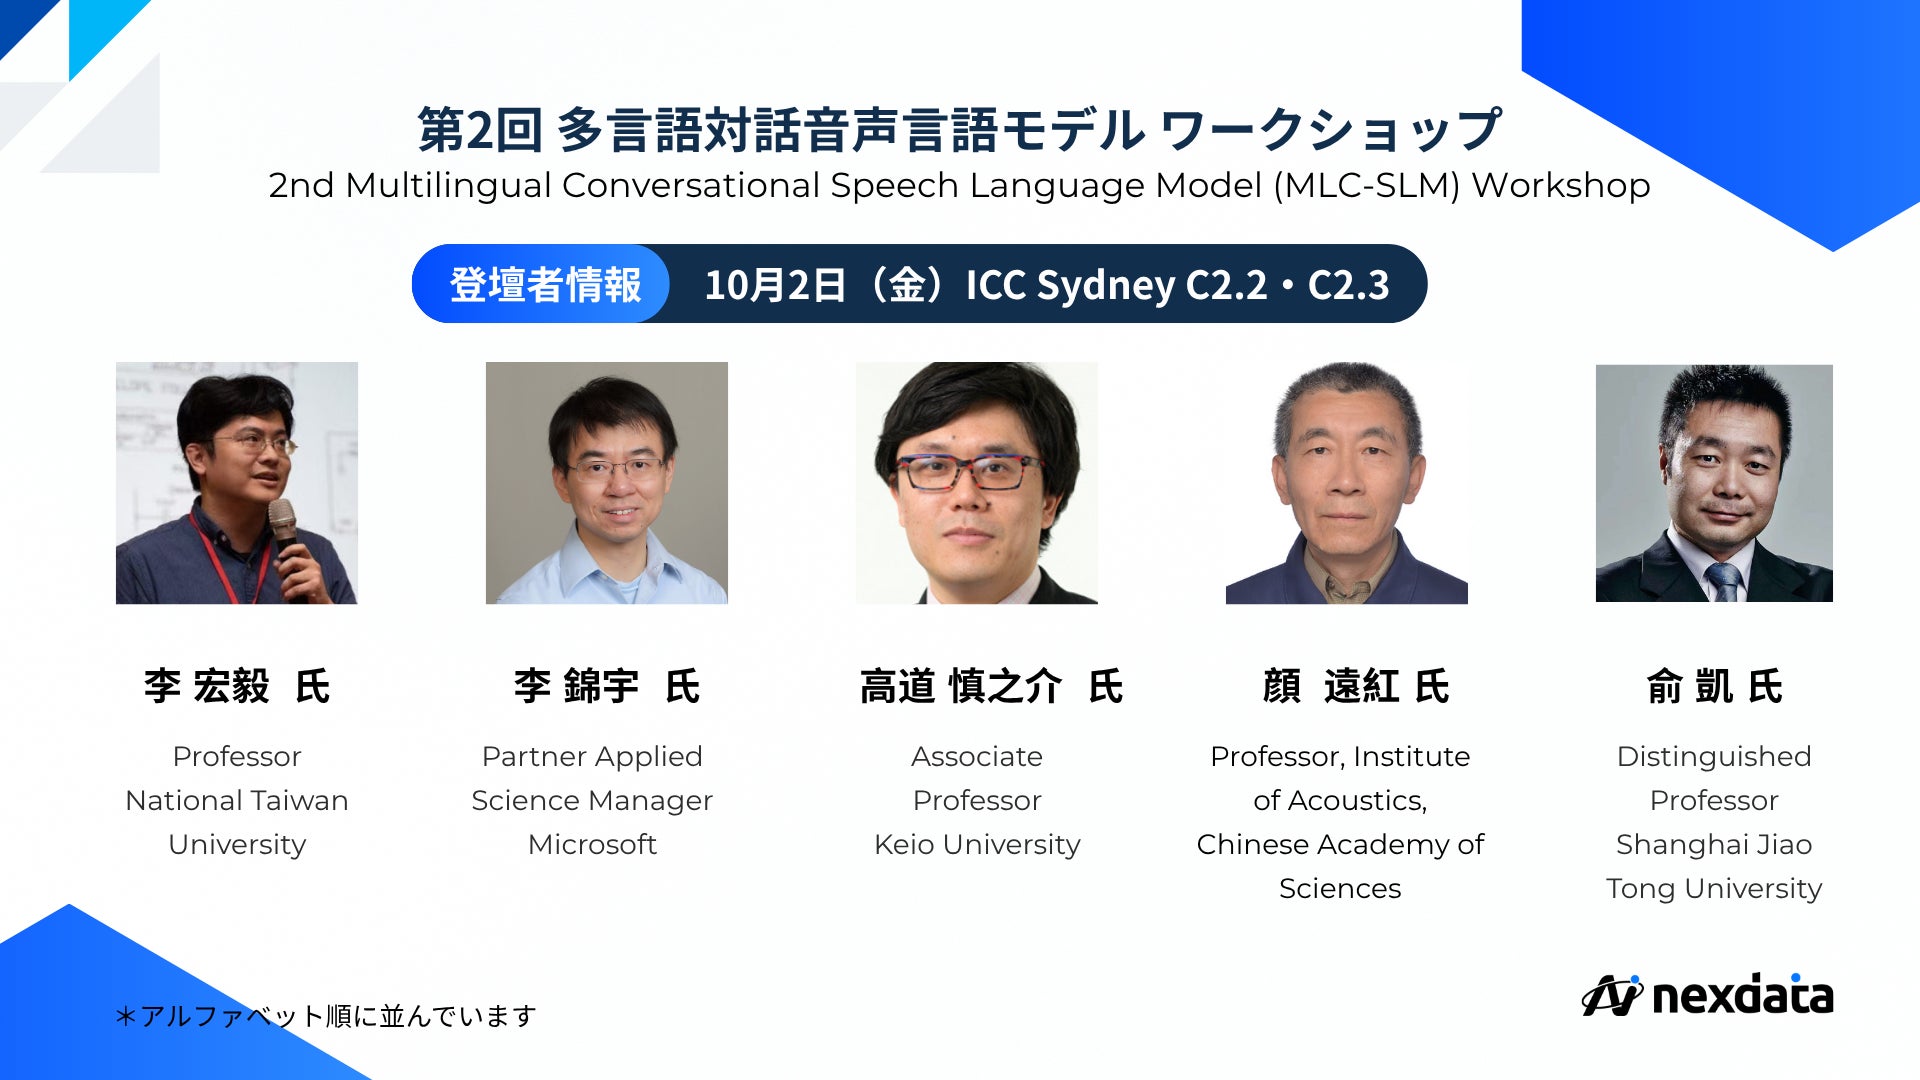
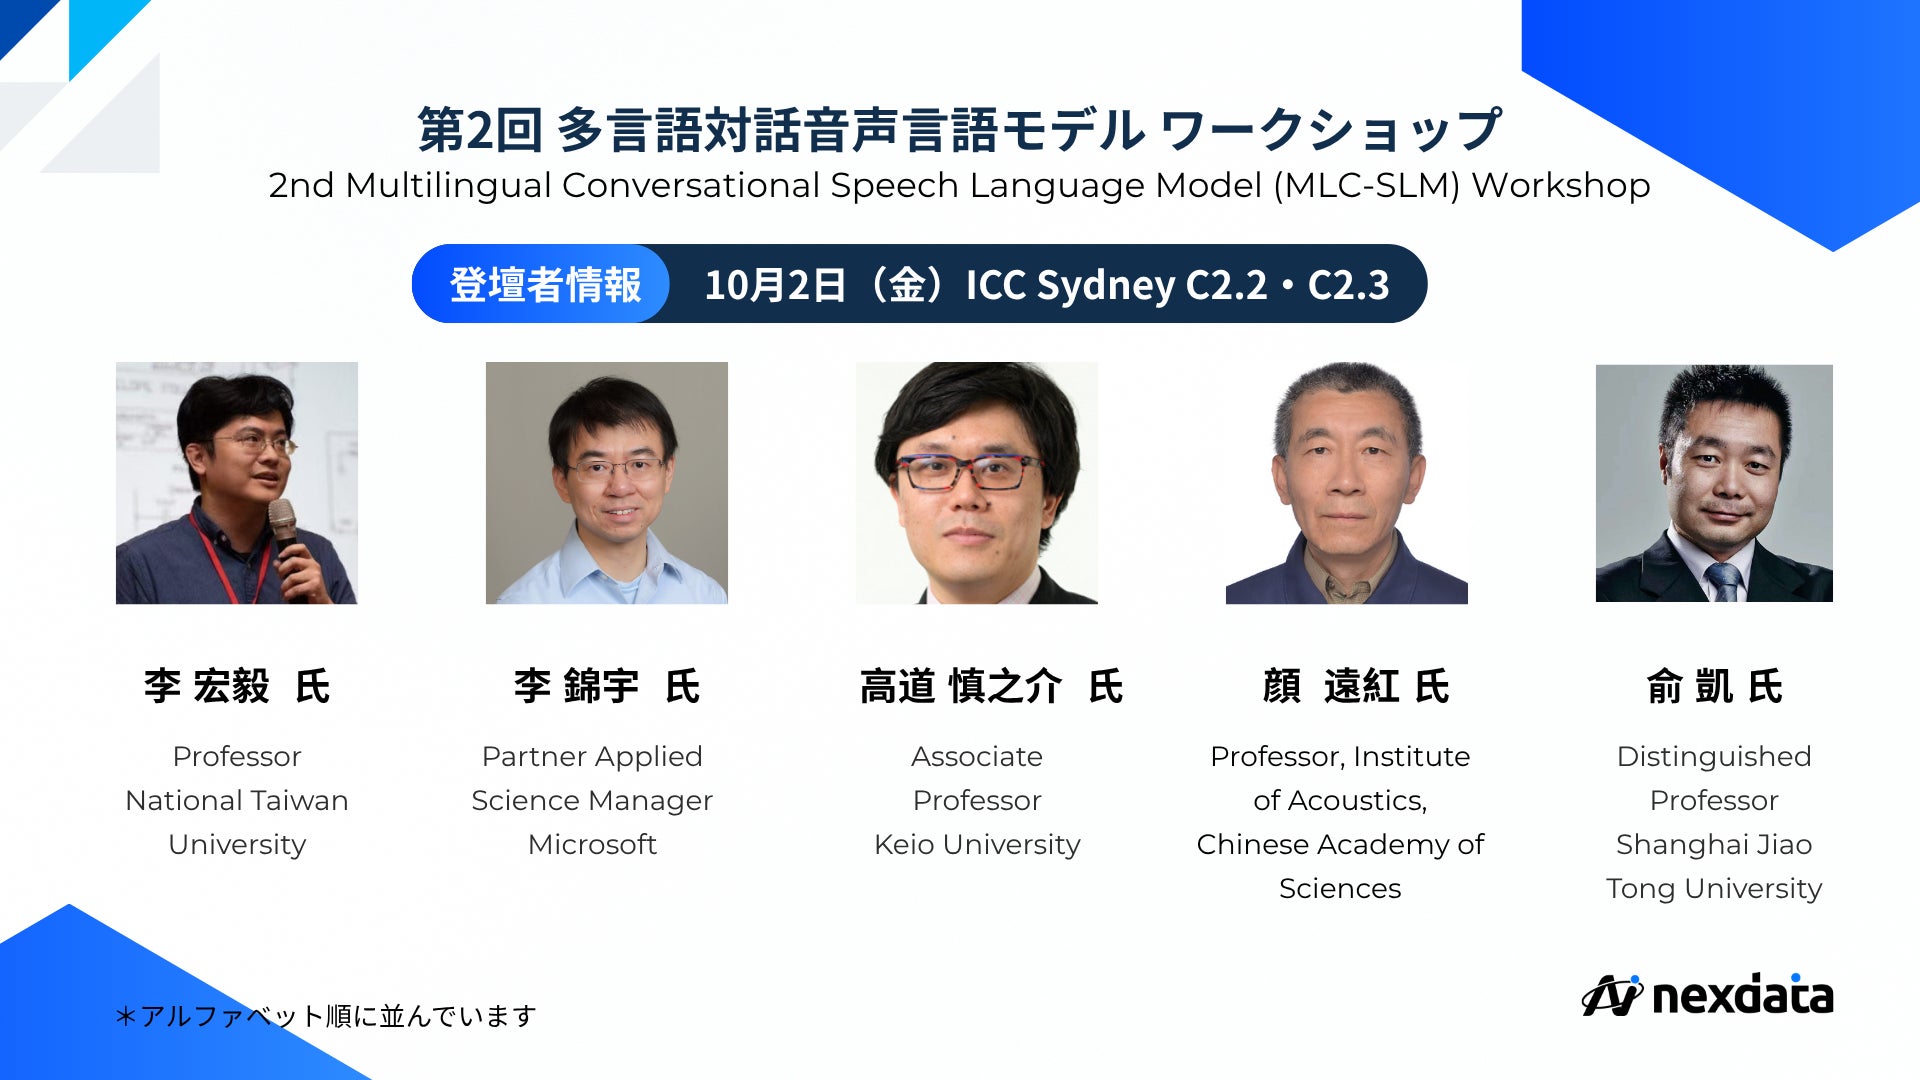
本出展では、音声認識・合成モデル、マルチモーダルモデルの開発に不可欠な高品質な学習データセットを紹介するほか、同カンファレンス内でNexdata主催ワークショップ「第2回多言語会話音声言語モデルワークショップコンテスト(MLC-SLM)」において、世界で有名な音声研究者が登壇し、最新技術の知見共有を行います。
出展概要
イベント名: Interspeech 2026
開催日程: 2026年9月27日(日)~ 10月1日(木)
開催地: オーストラリア・シドニー
Nexdataブース: E5
公式サイト:https://interspeech2026.org/en-AU
世界100以上の言語をカバー、200万時間以上の音声データを展示
NexdataはInterspeech 2026のブースにおいて蓄積・提供する大規模・アノテーション済み音声なデータセットを紹介いたします。その規模は現在200万時間を超え、世界100以上の言語を網羅しています。特に、日本語、英語、中国語、韓国語、スペイン語などの主要言語に加え、アラビア語などアジア圏の言語データにも強みを持っています。
音声データセットを見るワークショップ「MLC-SLM」開催
Interspeech 2026の期間中、Nexdataは公式ワークショップ「第2回多言語会話音声言語モデルワークショップコンテスト(MLC-SLM)」を主催いたします。LLMを音声対話モデルに応用する研究が加速する一方、自然な会話の複雑さを捉えた「多言語の現実世界データ」の不足が大きな課題となっています。
Nexdataは高精度な多言語会話音声言語モデルの構築と、実世界に即したデータセットの拡充を目的としたワークショップを開催します。前回の成功を踏まえ、対象言語やタスクをさらに拡張した 「第2回」 として、音声認識技術の更なる発展に貢献してまいります。
【ワークショッププログラム】
-
8:30 - 9:00 受付
-
9:00 - 9:45 基調講演 1: 顔 遠紅 氏
-
9:45 - 10:30 基調講演 2: 李 錦宇 氏
-
10:30 - 11:00 コーヒーブレイク
-
11:00 - 11:30 チャレンジ概要 + 表彰式
-
11:30 - 12:00 口頭発表セッション
-
12:00 - 13:00 昼食休憩
-
13:00 - 13:45 基調講演 3: 俞 凱 ⽒
-
13:45 - 14:30 口頭発表セッション
-
14:30 - 15:00 基調講演 4: 李 宏毅 ⽒
-
15:45 - 16:30 基調講演 5: 高道 慎之介 ⽒
-
16:30 - 17:00 ポスターセッション
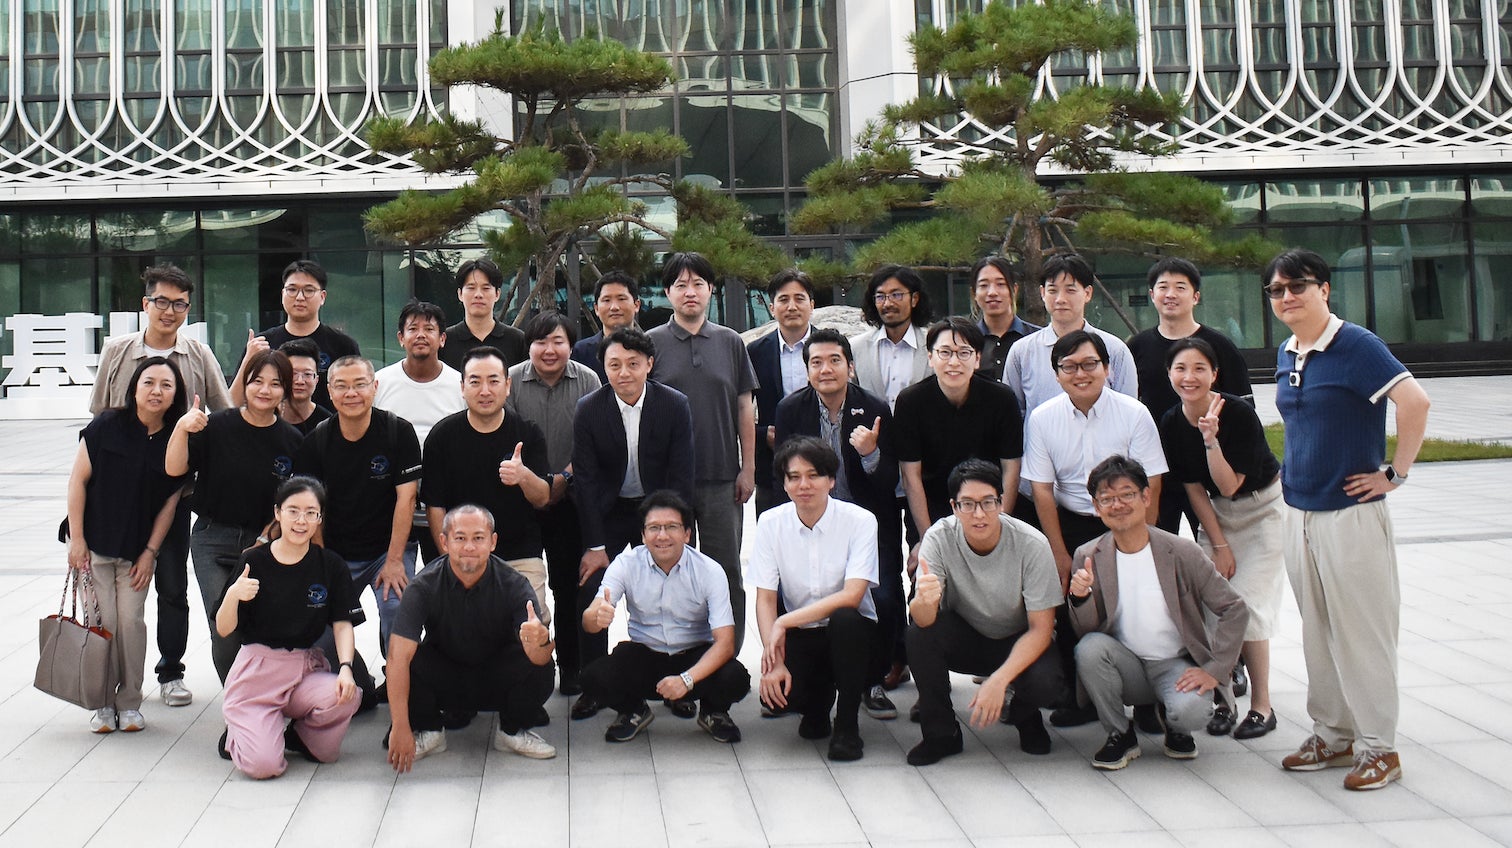
Interspeechの会場にて、皆様と直接お会いし、有意義な交流ができることを心より楽しみにしております。
Datatang株式会社について
社 名 : データ・タング株式会社(Datatang株式会社)
ブランド名:Nexdata(ネクスデータ)
所在地 : 東京都千代田区神田淡路町2-105ワテラスアネックス6階
設 立 : 2020年2月
事業概要:AI学習データ提供事業(自社データ・カスタマイズデータ)
AI学習データの収集・アノテーション ・プラットフォーム提供事業
URL : https://nexdata.jp/
Zero Press のデータで見るこのリリース
- 配信元
- Datatang株式会社(Zero Press 掲載 3 本)
- 配信サイト
- PR TIMES
- カテゴリ
- イベント
- 直近 7 日の配信
- イベント 3,977 本 / 全体 13,833 本
Zero Press が取り込んだ配信データから自動集計しています。カテゴリ別・業界別のより詳しい分析は週間動向レポートで毎週公開しています。
このジャンルのリリースを書くときのガイド
-
a flood of circle、トリビュートアルバムの参加アーティストを連日発表、第1弾はLiSA
株式会社テイチクエンタテインメント
-
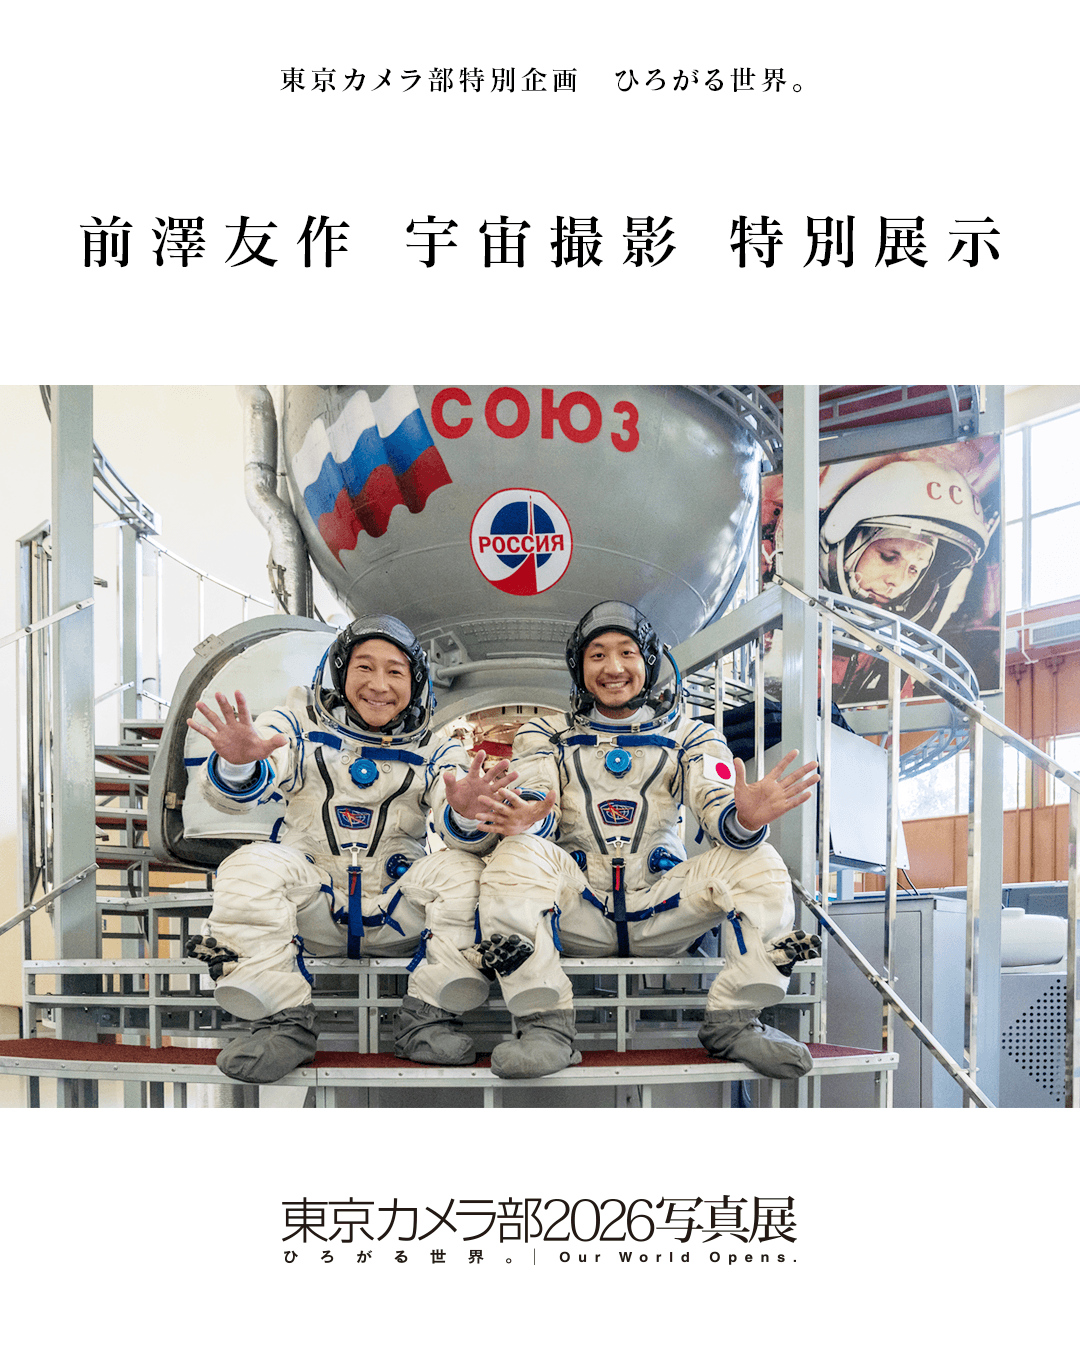
「東京カメラ部2026写真展」に、特別展示として前澤友作さん、平野陽三さんの「宇宙」作品を展示
東京カメラ部株式会社
-
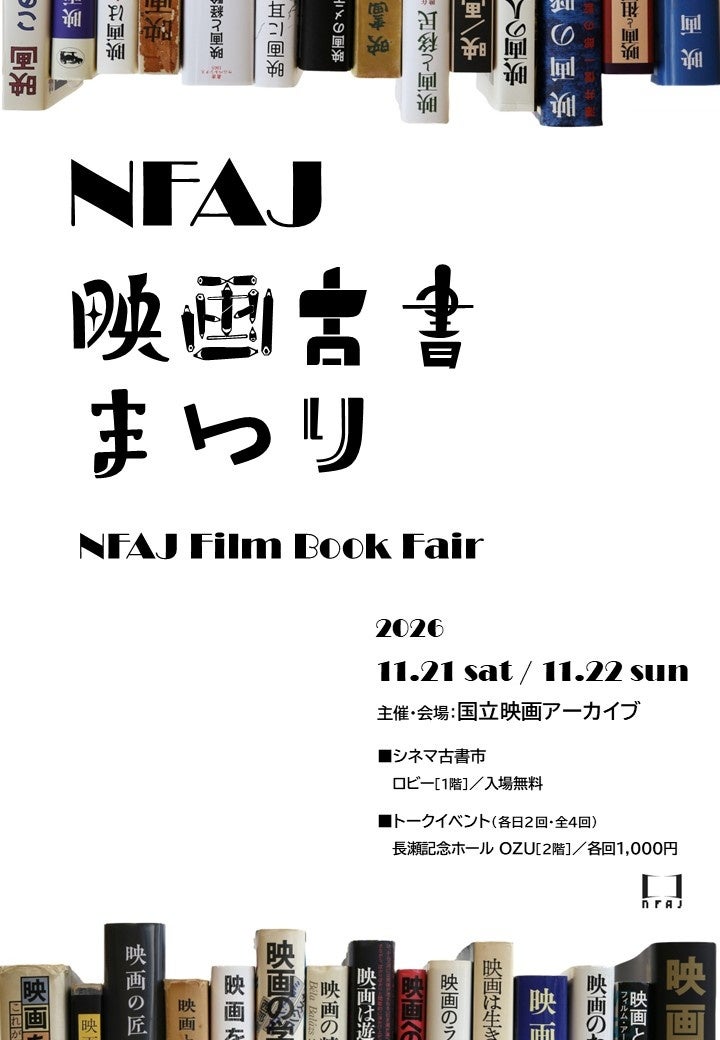
【国立映画アーカイブ】イベント「NFAJ映画古書まつり」開催のお知らせ
文化庁
-
9月27日(日)、東京・新宿「日本茶コレクション2026」にて狭山和紅茶セミナーを開催!2027年1月「第24回 全国地紅茶サミット in SAYAMA」に向けて生産者3園が登壇
狭山市役所
-
ノジマTリーグ 2026-2027シーズン 公式戦 9月19日開催 木下アビエル神奈川 vs 日本生命レッドエルフ オーダー発表
一般社団法人Tリーグ
-
ノジマTリーグ 2026-2027 公式戦 9月19日開催 岡山リベッツ vs T.T彩たま 試合結果
一般社団法人Tリーグ
-
【楽天市場に登場】根本からフワッと! 発毛促進、脱毛予防をサポートする3種の有効成分と頭皮を潤す桑白皮エキス配合の 薬用育毛剤『KAMIO+(カミオタス)』発売開始!
株式会社フレージュ
-

横濱コーポレーション、「管理戸数ランキング2026」にて【神奈川県内第6位】を獲得。管理戸数は11,000戸を突破
横濱コーポレーション
-
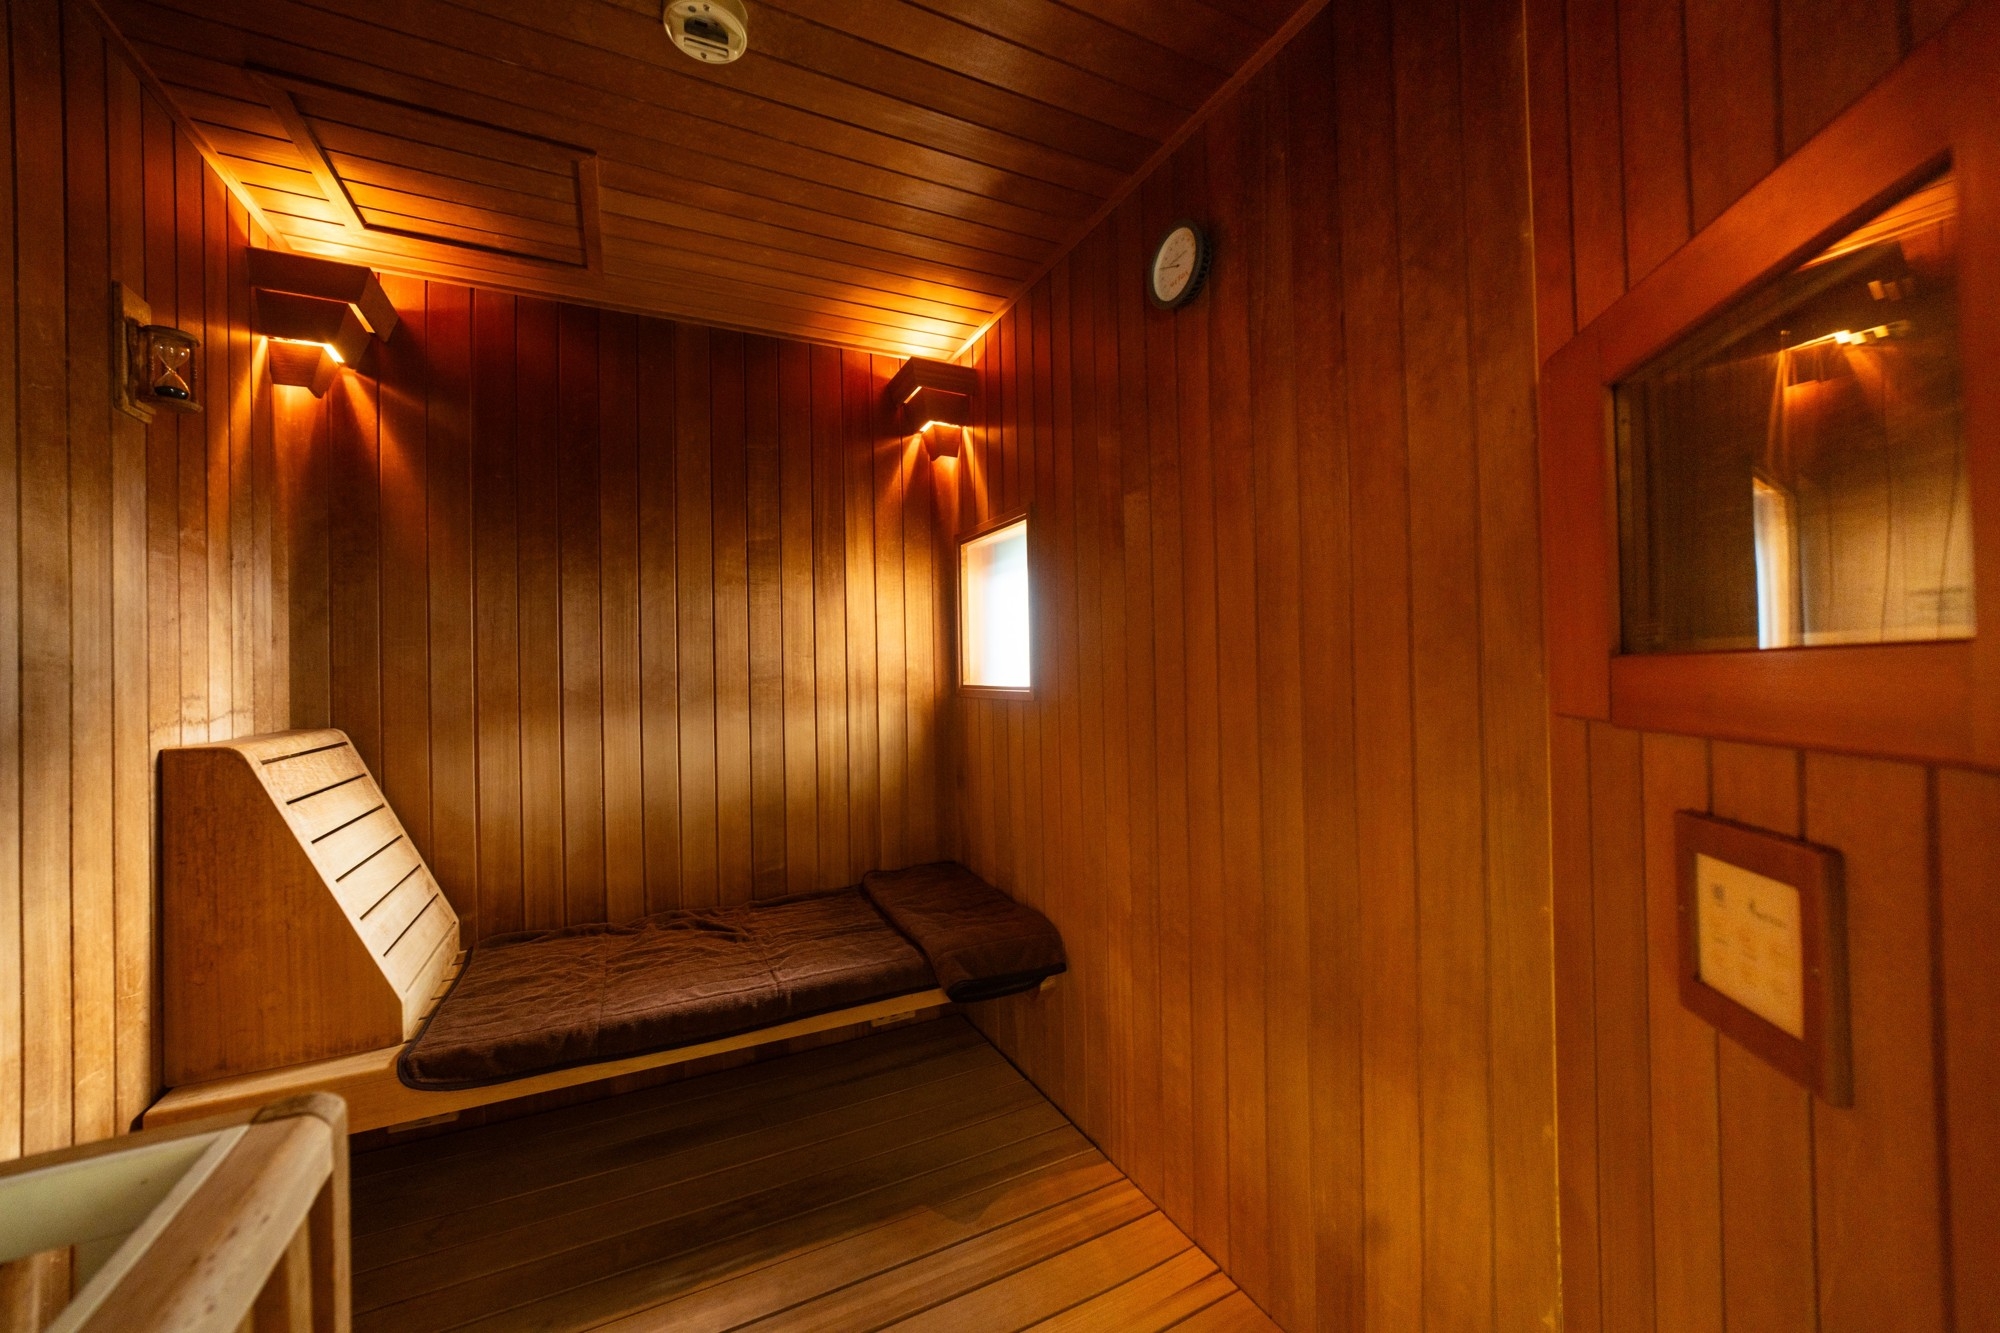
淡路島で「もう一回」大切な人と一緒に入る、プライベートサウナ旅 「異世界へ誘うリゾート」も「私たちだけのヴィラ」も、一棟貸しで Villa Mon Temps AWAJI / THE GOAT AWAJI
株式会社ぷらど
-
データセンターおよびクラウド・ネットワーキング向けEMLレーザーの世界市場(2026年~2032年)、市場規模(10~25GBd、25GBd以上)・分析レポートを発表
株式会社マーケットリサーチセンター
-
高周波・高速プリント基板の世界市場(2026年~2032年)、市場規模(高速PCB、高周波PCB)・分析レポートを発表
株式会社マーケットリサーチセンター
-
4K AI搭載カメラの世界市場(2026年~2032年)、市場規模(4K AIセキュリティカメラ、4K AI会議用カメラ、4K AI PTZカメラ、4K AIウェブカメラ)・分析レポートを発表
株式会社マーケットリサーチセンター